政府機関や軍事機関、より広範なインテリジェンスコミュニティ、大企業が実施する現代の調査はすべて、膨大な量の非構造化データの中から「誰が誰で、何が何か」を正確に把握することに依存しています。エンティティ抽出(「named entity recognition」とも呼ばれる)は、非構造化データソースから人物、組織、日付、場所などのエンティティを抽出する自然言語処理技術です。密接に関連するプロセスである「entity resolution」とあわせて、エンティティ抽出は生データを実用的なインテリジェンスへと変換するうえでの重要なステップです。
エンティティ抽出の仕組み
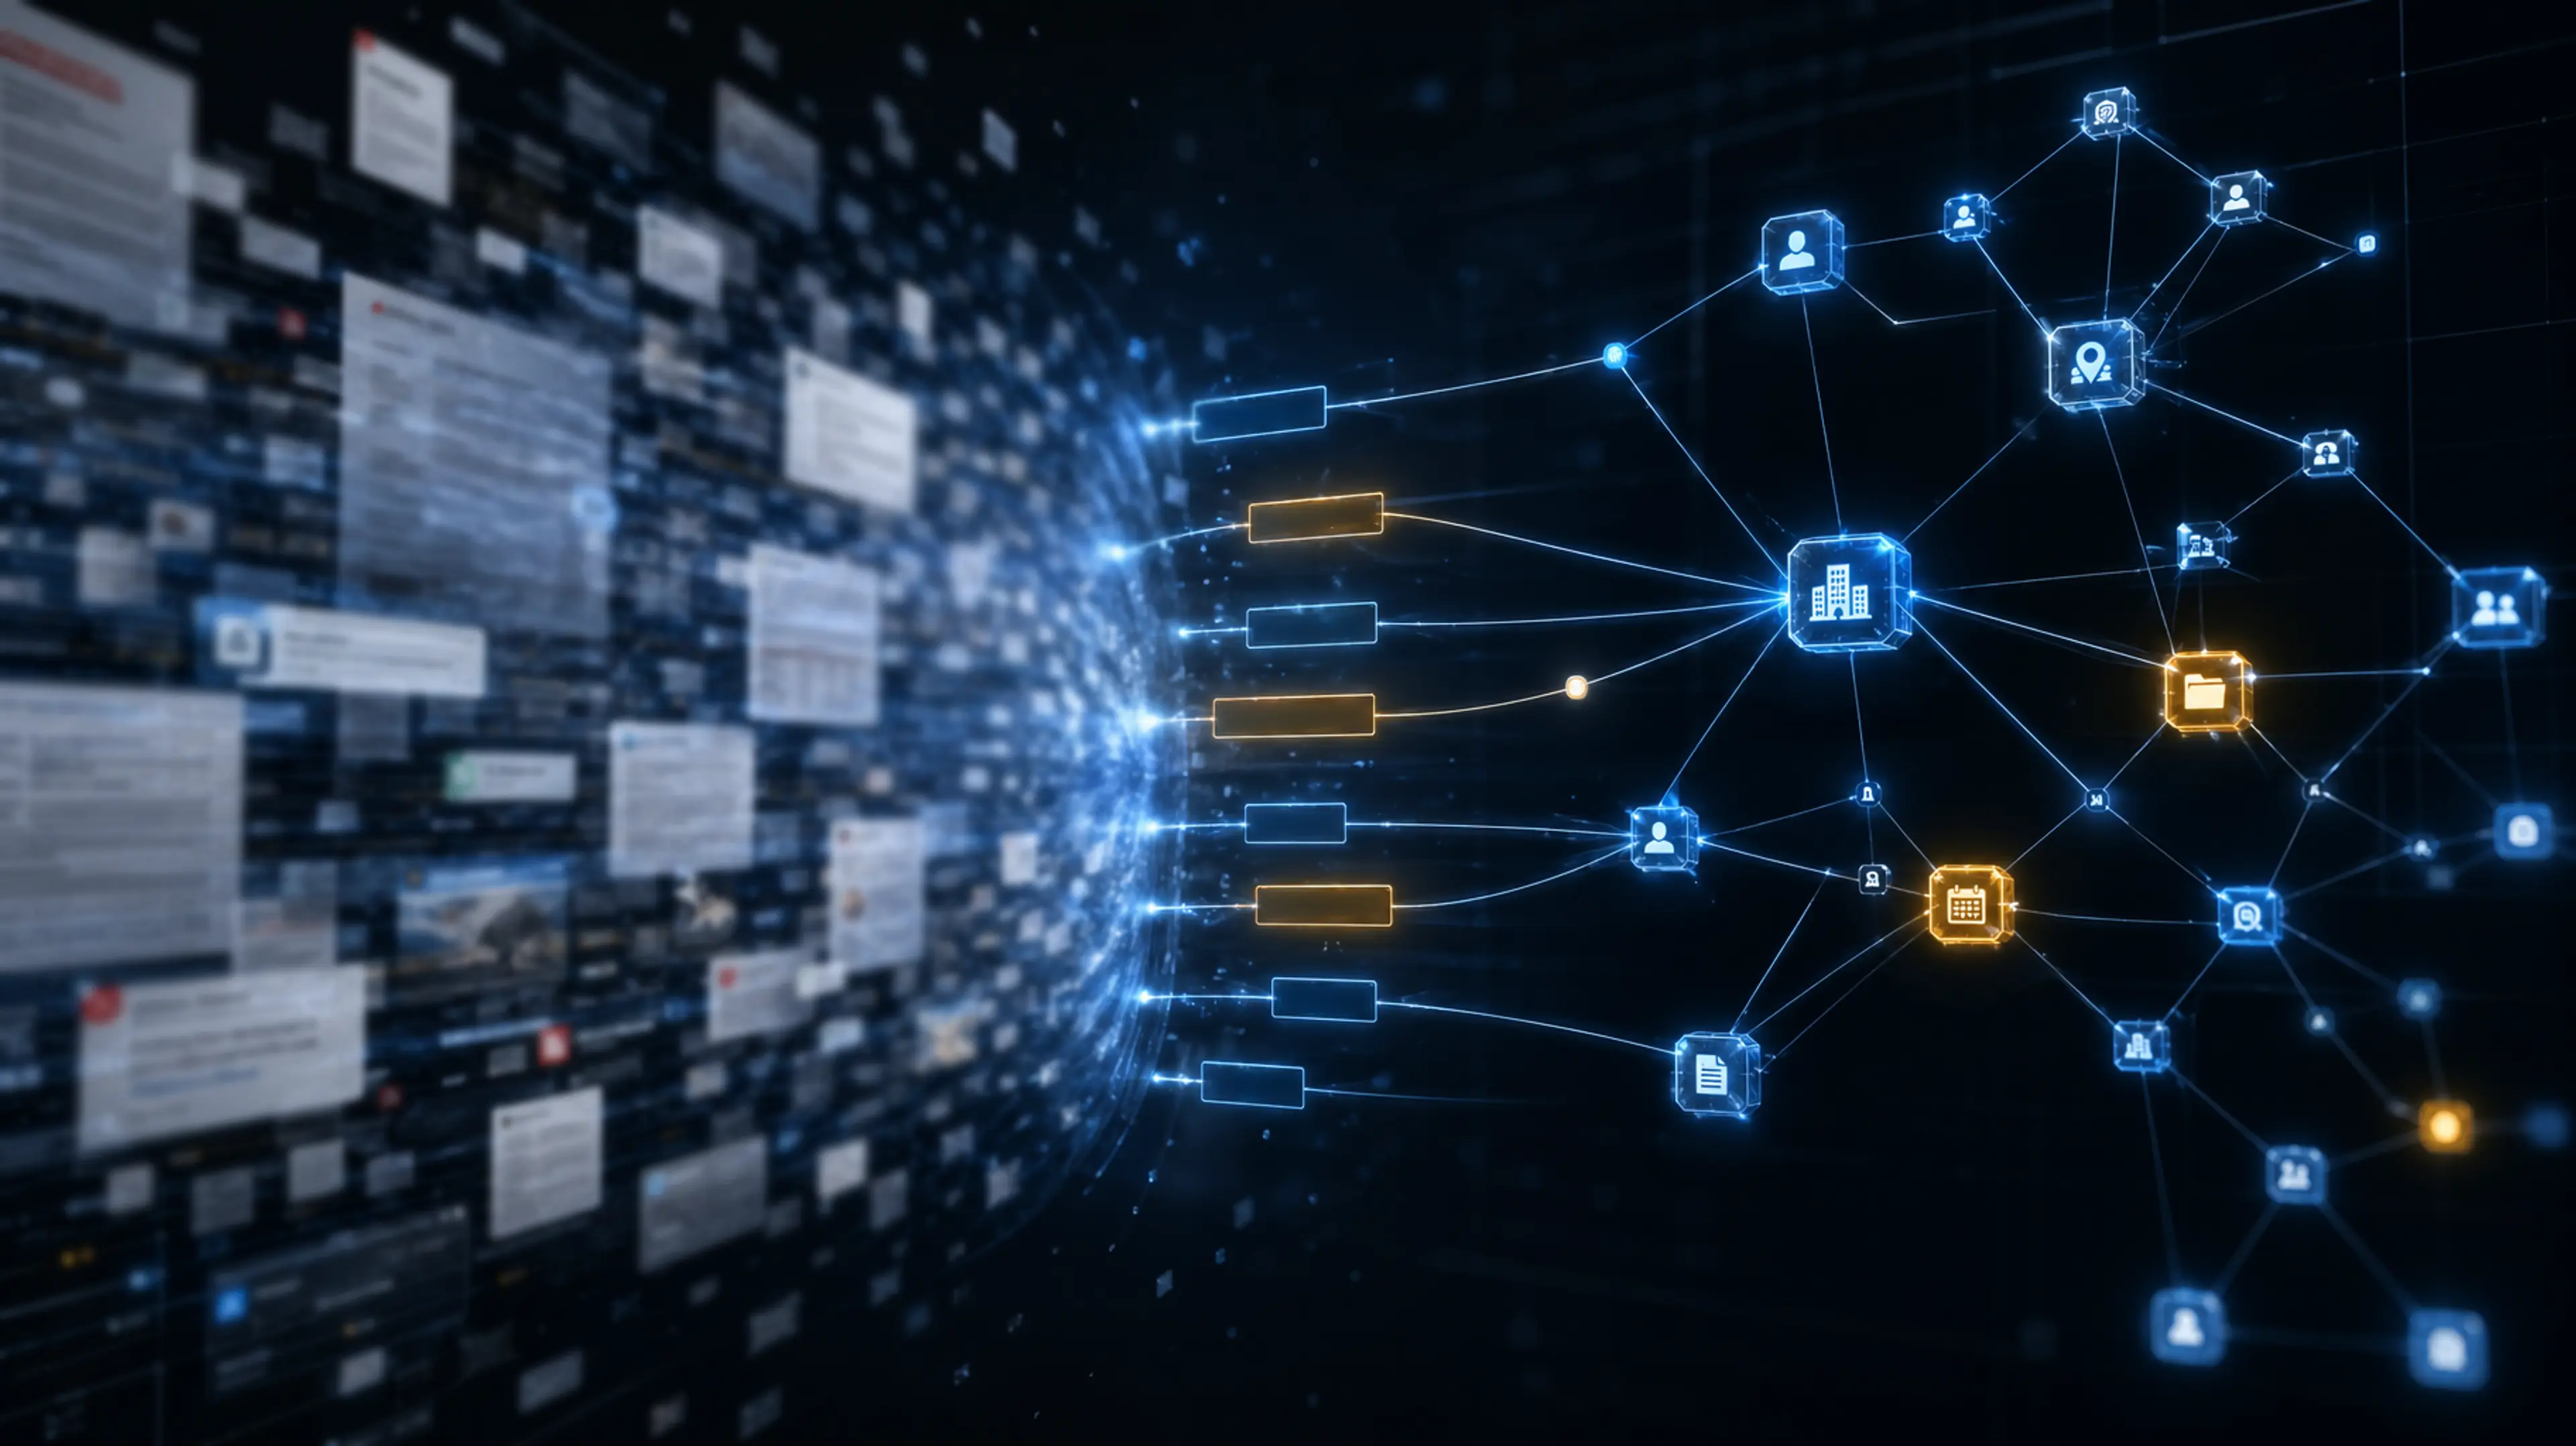
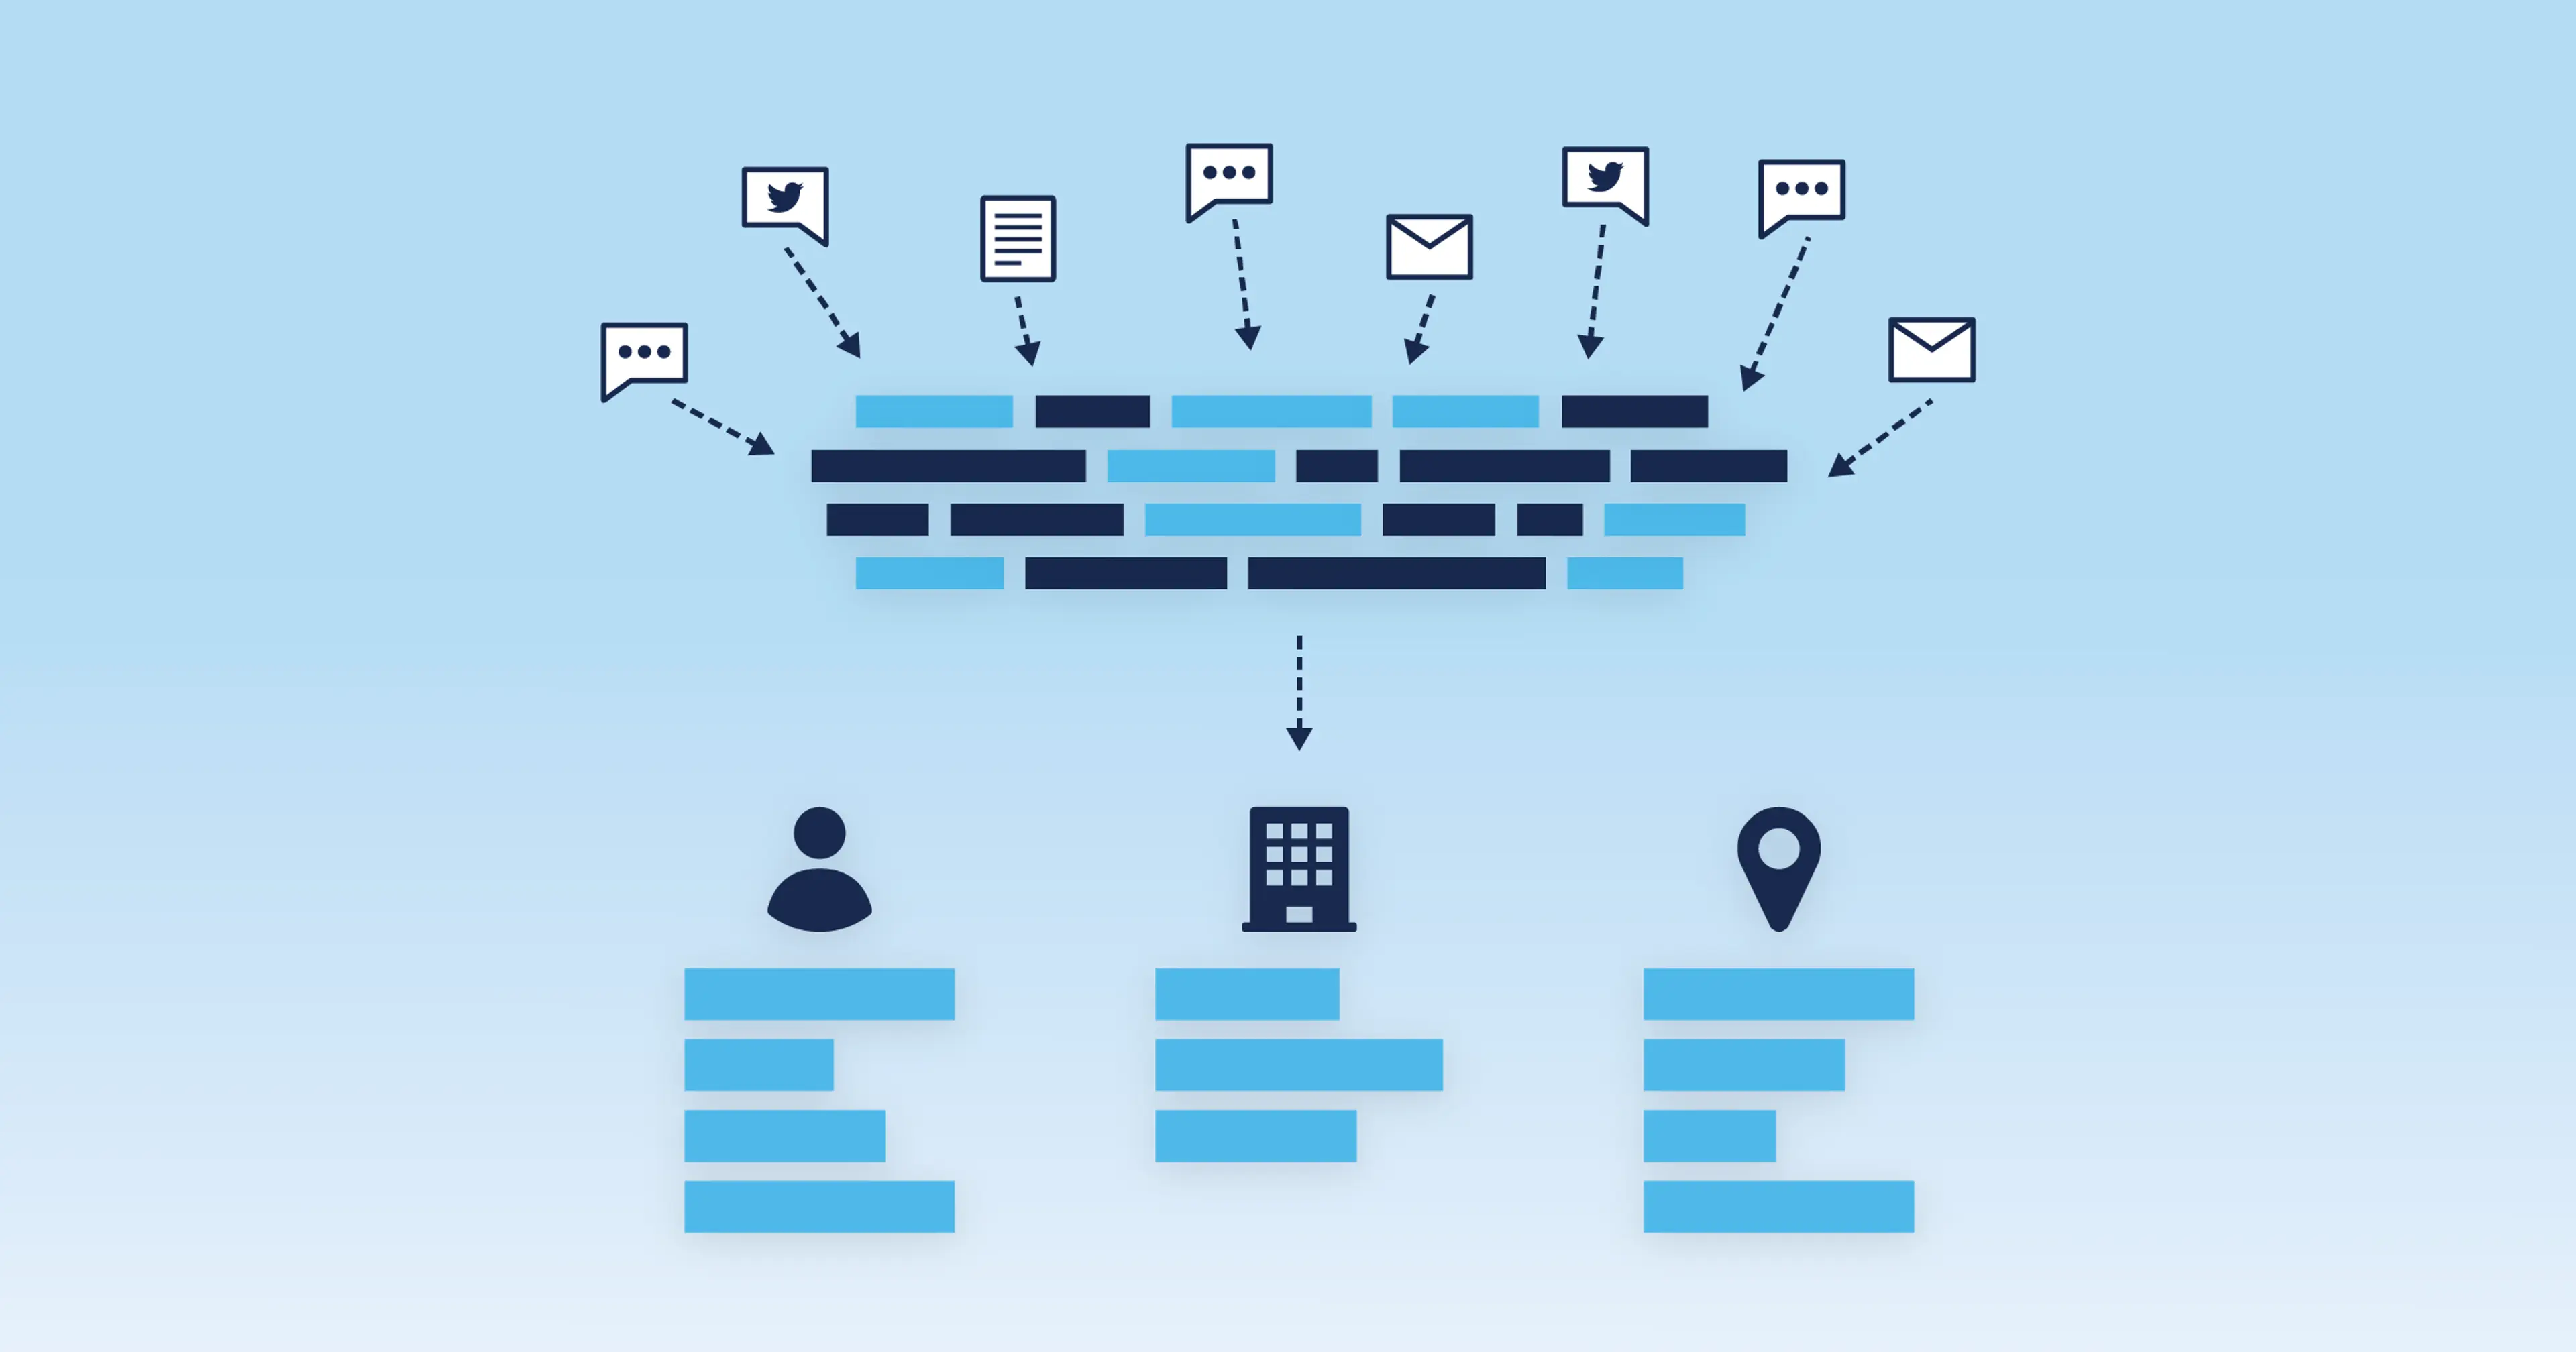
エンティティ抽出システムが、ソーシャルメディアの投稿、ニュース記事、掲示板でのやり取り、政府記録、企業レポート、ブログ、個人サイト、音声書き起こしなど、何十億件もの非構造化データを読み込んでいるところを想像してください。その多くから得られるエンティティ情報はごくわずかです。システムは猫に関する詩や映画レビュー、AI生成レシピなどを次々とスキャンしていきます。すると突然、地方紙の記事の中で次の一文に出会います。
6月に、ケネディ氏はドミニカを訪問した。
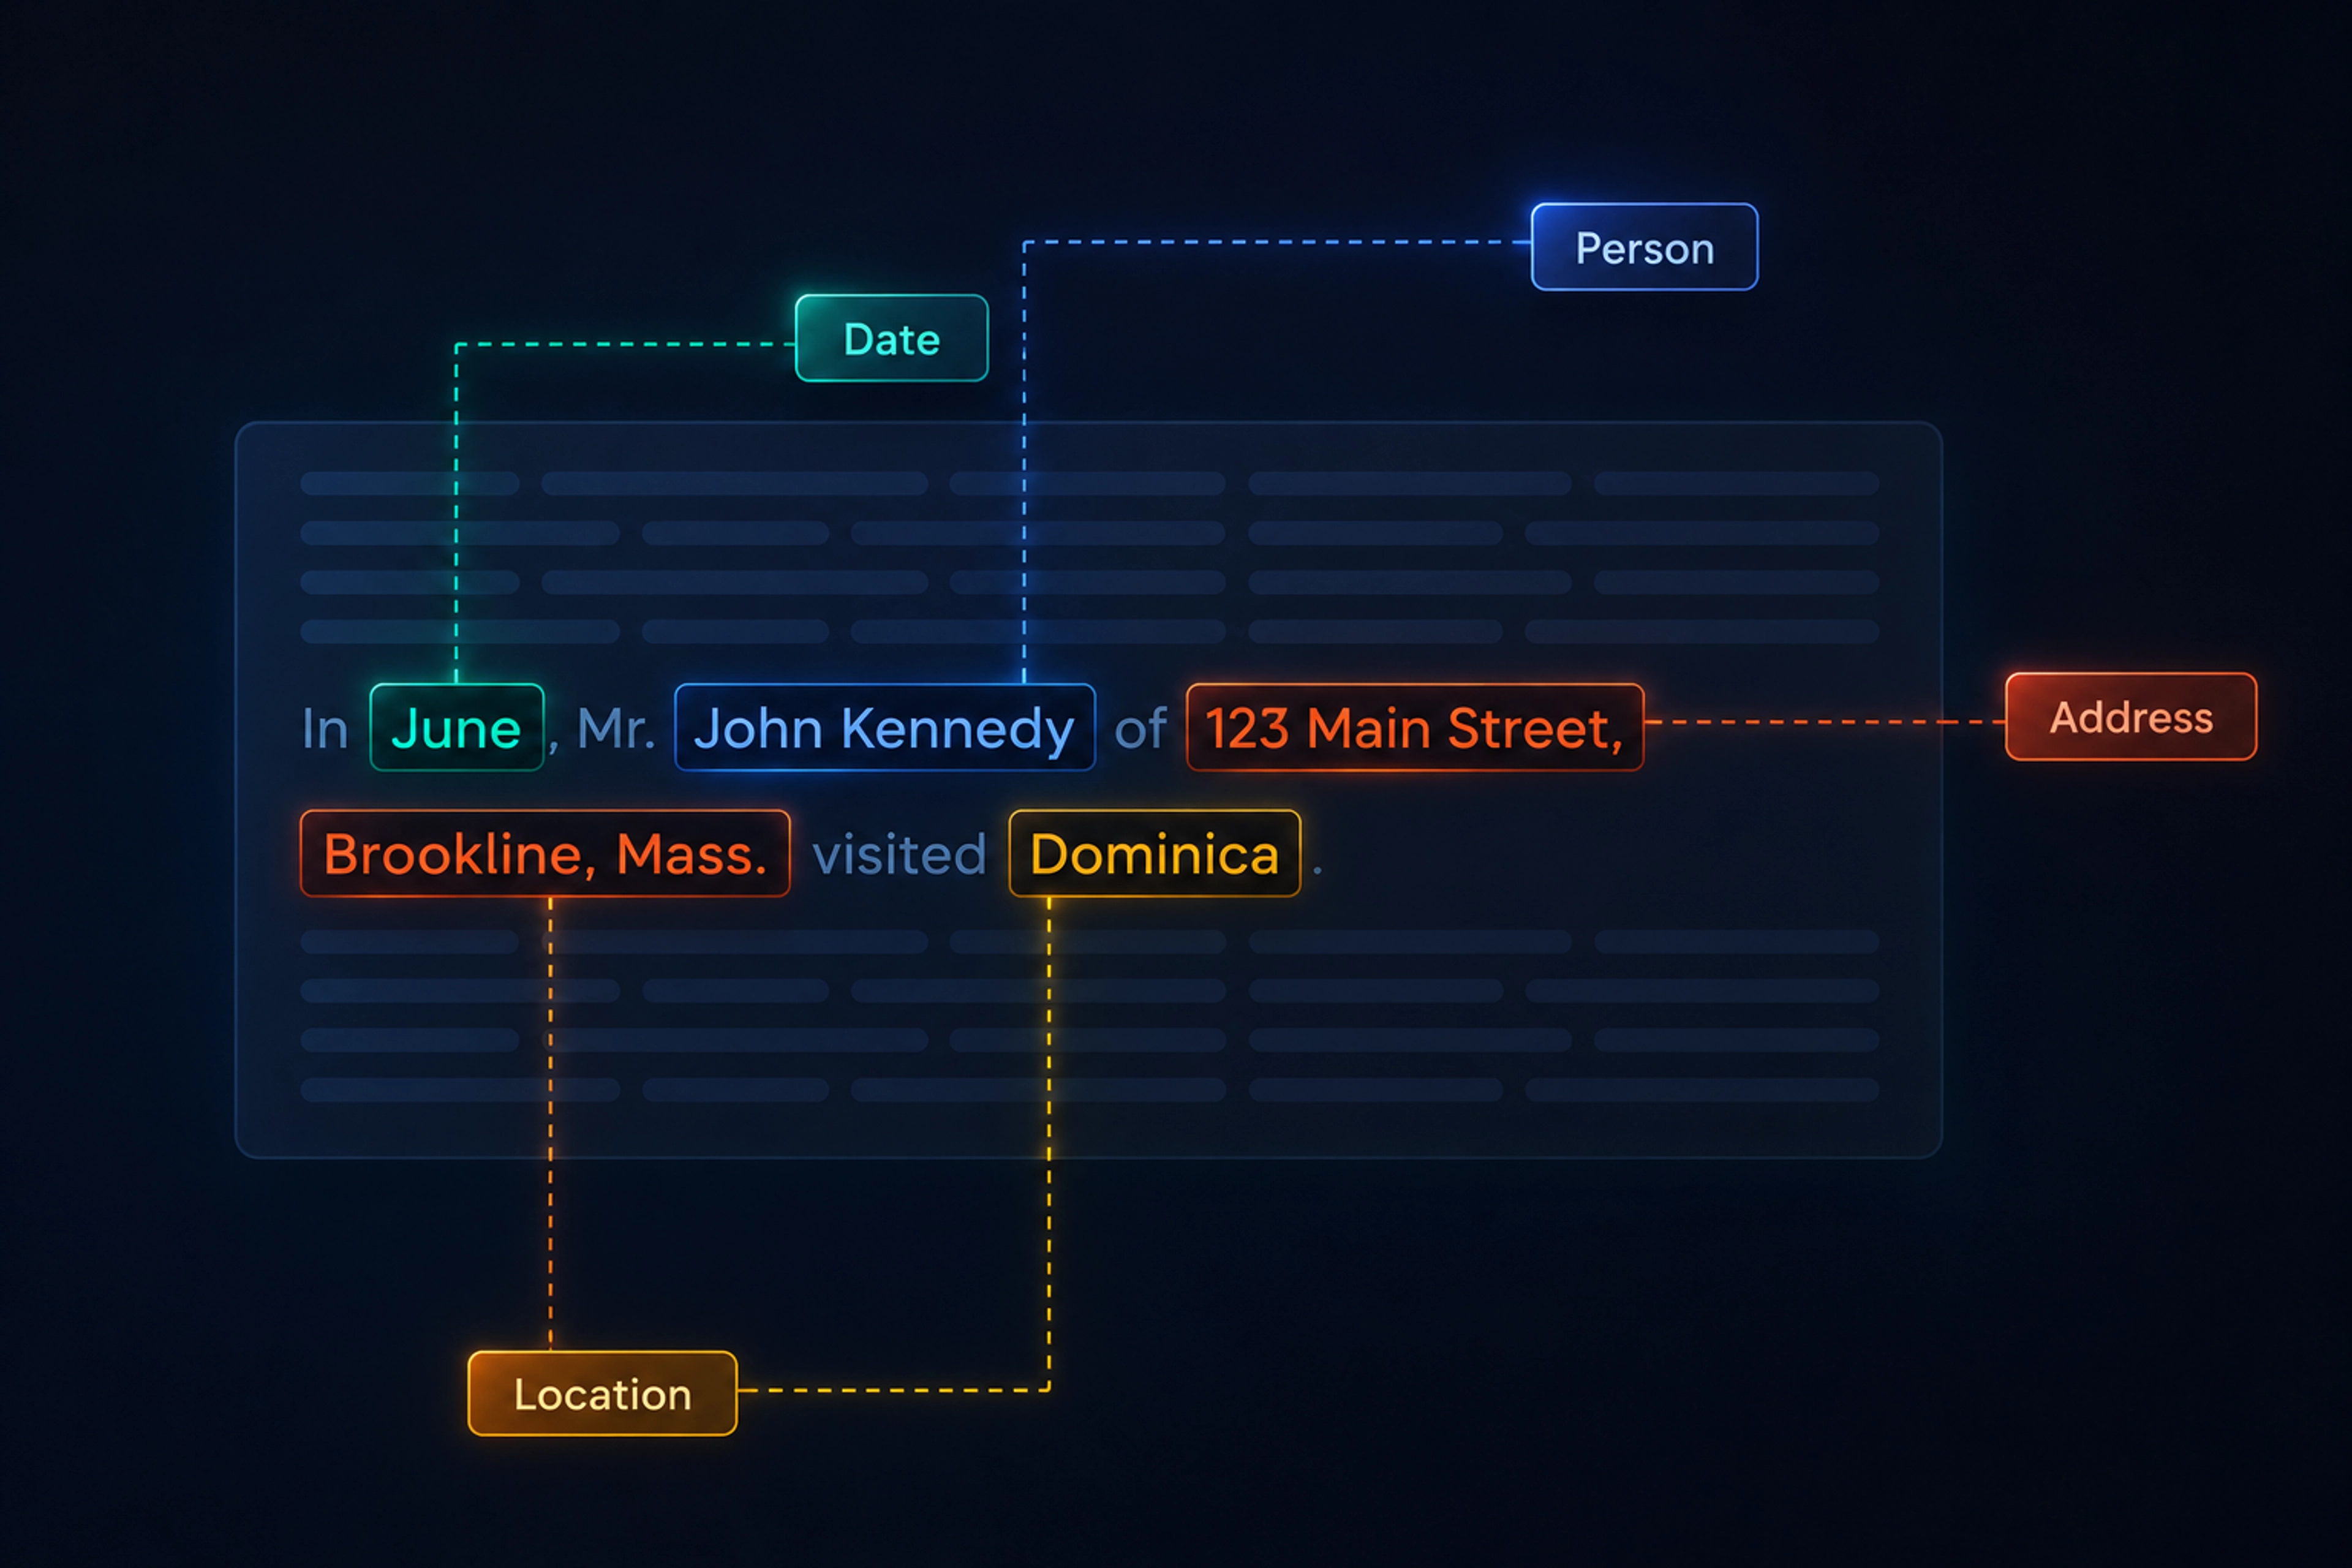
この文の中の特定の単語や単語パターンによって、システムは3つのエンティティ(June、Kennedy、Dominica)が存在することを検知します。システムはそれぞれのエンティティを、あらかじめ定義されたカテゴリ(人物、組織、場所、日付・時間、その他のカテゴリ)に分類し、各エンティティについて構造化されたレコードを作成します。
AI を活用した分類アルゴリズムは、文脈上の手がかりやその他のインサイトを利用して、この文において次のように判断します。
- June は月、つまり日付の一部であり、女性の名前ではありません(「in」という語が使われていることから分かります)
- ケネディは人物であり、ペンシルベニア州アレゲニー郡のタウンシップではありません(敬称「Mr.」が使われていることなどから判断)
- ドミニカ は人物ではなく、場所/国家です(姓が示されていないことから推測される)
この単純な文からシステムが抽出できるエンティティ情報は、これだけかもしれません。しかし、Kennedy の旅行を報じる新聞が、もう少し詳しく書いたとしましょう。そこには次のような一文が掲載されていました。
6月に、マサチューセッツ州ブルックラインのメインストリート123番地に住むJohn Kennedy氏がドミニカを訪れた。
エンティティ抽出システムは、この追加情報を検出します。その情報を標準化するとともに、Kennedy のレコードに付加します。その結果、「Mr. John Kennedy of 123 Main Street, Brookline, Mass.」は、次のようなレコードになります。
名: John
姓: Kennedy
番地: 123
通りの名称: Main
市区町村: Brookline
州: MA
このプロセスの中で、エンティティ抽出システムがレコードをさらに充実させる場合もあります。例えば、住所に ZIP+4 コードや位置情報の座標が付与されることがあります。また、名前に推定される性別が付加される場合もあります。
次のステップ:エンティティ解決
エンティティが抽出されると、エンティティ解決を実行できます。エンティティ解決とは、巨大かつ変化し続けるデータセットの内部および相互において、同一のエンティティを指すレコードを特定し、関連付けるプロセスです。
これはエンティティ抽出とどのように異なるのか
エンティティ抽出によって、「John Kennedy」という人物名の言及はすでに検出されています。ですが、そのJohn Kennedyとは誰でしょうか。大統領でしょうか。大統領の息子でしょうか。それとも、世界中にいる何千人ものJohn Kennedyという同姓同名のうちの別人でしょうか。
組織は、この種の判断を行うためにエンティティ解決を必要としています。これがなければ、U.S. Department of State は、家族とともにニューヨーク市へのビザを申請しているロンドン在住の教師 Kareem Al-Hassan が、Captagon 密売人の Kareem Al-Hassan と同一人物なのか、あるいは、建築遺産を略奪し米国へ文化財を密輸していることで知られる كريم حسن と同一人物なのかを把握できません。法執行機関は、異なる捜査管轄区域で同一の犯罪者が使用している別名同士を結び付けることができません。民間セクターでは、金融機関は制裁リストと氏名を十分に照合することができません。
エンティティ解決は、政府、軍、インテリジェンス機関、そして民間組織がこうした関連性を把握するうえでどのように役立つのでしょうか。エンティティ解決ツールは膨大な量のPAIを精査し、識別情報を見つけ出して各エンティティ名に付与します。これらの識別子には、年齢、性別、住所、メールアドレス、電話番号、家族関係、雇用状況、学歴などが含まれます。識別子を用いることで、アナリストや捜査担当者は、あるJohn Kennedyと別のJohn Kennedy、あるKareem Al-Hassanと別のKareem Al-Hassanを結び付けたり区別したりすることができます。同様の識別子は、企業エンティティにも適用できます。
Babel Street がどのように支援できるか
エンティティ抽出は、Babel Street Agentic Risk Intelligence Platformの重要な構成要素です。これは、統制されたAIエージェントが実行・統合し、構造化された意思決定可能なインテリジェンスを提供する、AIネイティブのオペレーショナルフレームワークです。アイデンティティリスクインテリジェンス、戦略的脅威インテリジェンス、ベンダーリスクインテリジェンスにおける新たな標準を打ち立てることで、このプラットフォームは、膨大なPAIを検索し、全体像を捉えた最新のインサイトを提供することにより、組織がダイナミックな脅威を先取りできるよう支援します。これらのインサイトは、他のプロバイダーがアクセスも再現もできない、権利処理済みでミッションに基づき厳選された多言語データの大規模なパイプラインに対するAI駆動の分析に基づいています。
人、組織、場所などを自動的に抽出し、言語の違いや名称の表記揺れ、フォーマット、文字種、文法構造、その他のデータ要素に左右されることなく処理することで、Babel Street は迅速で信頼性の高いインサイトを提供します。
当社のAIベースのエンティティ抽出は、機械学習モデルを用いてテキストを解析し、データが当社システムに取り込まれる際にエンティティを自動的に抽出・付加情報化します。この機能により、エンティティを単なるテキスト文字列ではなく、第一級の分析対象オブジェクトとして扱うことで、発見性を高め、大規模な分析を可能にします。さらに、Babel Streetは主要なエンティティをメタデータとして特定・インデックス化します。このメタデータは、さまざまなワークフローを通じて保持されます。
追加のエンティティ抽出機能には次のものがあります:
- ネイティブ言語処理 — 多くのプラットフォームはエンティティを抽出する前にデータを英語へ翻訳しますが、このプロセスは、とくにアラビア語、中国語、日本語、韓国語、ペルシア語、ロシア語のような複雑な言語で書かれた文書からエンティティを抽出する場合、誤りが重なって発生する原因となります。Babel Street は、ネイティブ言語のテキストから直接エンティティを抽出することで、誤りが生じる可能性を最小限に抑えます。
- エンティティベースの絞り込み — この機能により、ユーザーはキーワードと組み合わせたエンティティフィルターを使って検索条件を構築し、抽出されたエンティティをドキュメント結果内に直接表示し、これらのエンティティによる絞り込みを活用してノイズを低減し検索精度を向上させることができます。
Babel Street と連携することで、政府機関、軍、情報機関、企業組織は次のような成果を得ることが期待できます。
- 大規模に一貫して得られるインテリジェンス
- 大規模かつ複雑なデータセットにおけるエンティティの迅速な発見
- 未知の調査環境をより深く理解
- 調査ワークフローの改善
Babel Street は10年以上にわたり、軍、国防、インテリジェンス、エンタープライズ分野のコミュニティに対し、ミッションクリティカルなリスクインテリジェンスを提供してきました。Babel Street Agentic Risk Intelligence Platformのエンティティ抽出機能は、国家を守り、組織を支え、より安全な世界を実現するインテリジェンスの基盤となっています。
エンティティ抽出の基本を学ぶ
Babel Street Insights Entity Extraction
What is Entity Extraction?
What’s the Difference Between Entity Extraction (NER) and Entity Resolution?
Entity extraction, or named entity recognition (NER), is finding mentions of key “things” (aka “entities”) such as people, places, organizations, dates, and tim...
Feature Spotlight: Enhanced Entity Extraction in Babel Street Insights
How entity extraction transforms unstructured data into actionable intelligence for OSINT teams
免責事項:
本書に登場する人物名、企業名、事象はすべて架空のものです。実在の人物(生死を問わず)、場所、企業、製品などとのいかなる関連性や同一性も意図したものではなく、そのように解釈されるべきではありません。
Published