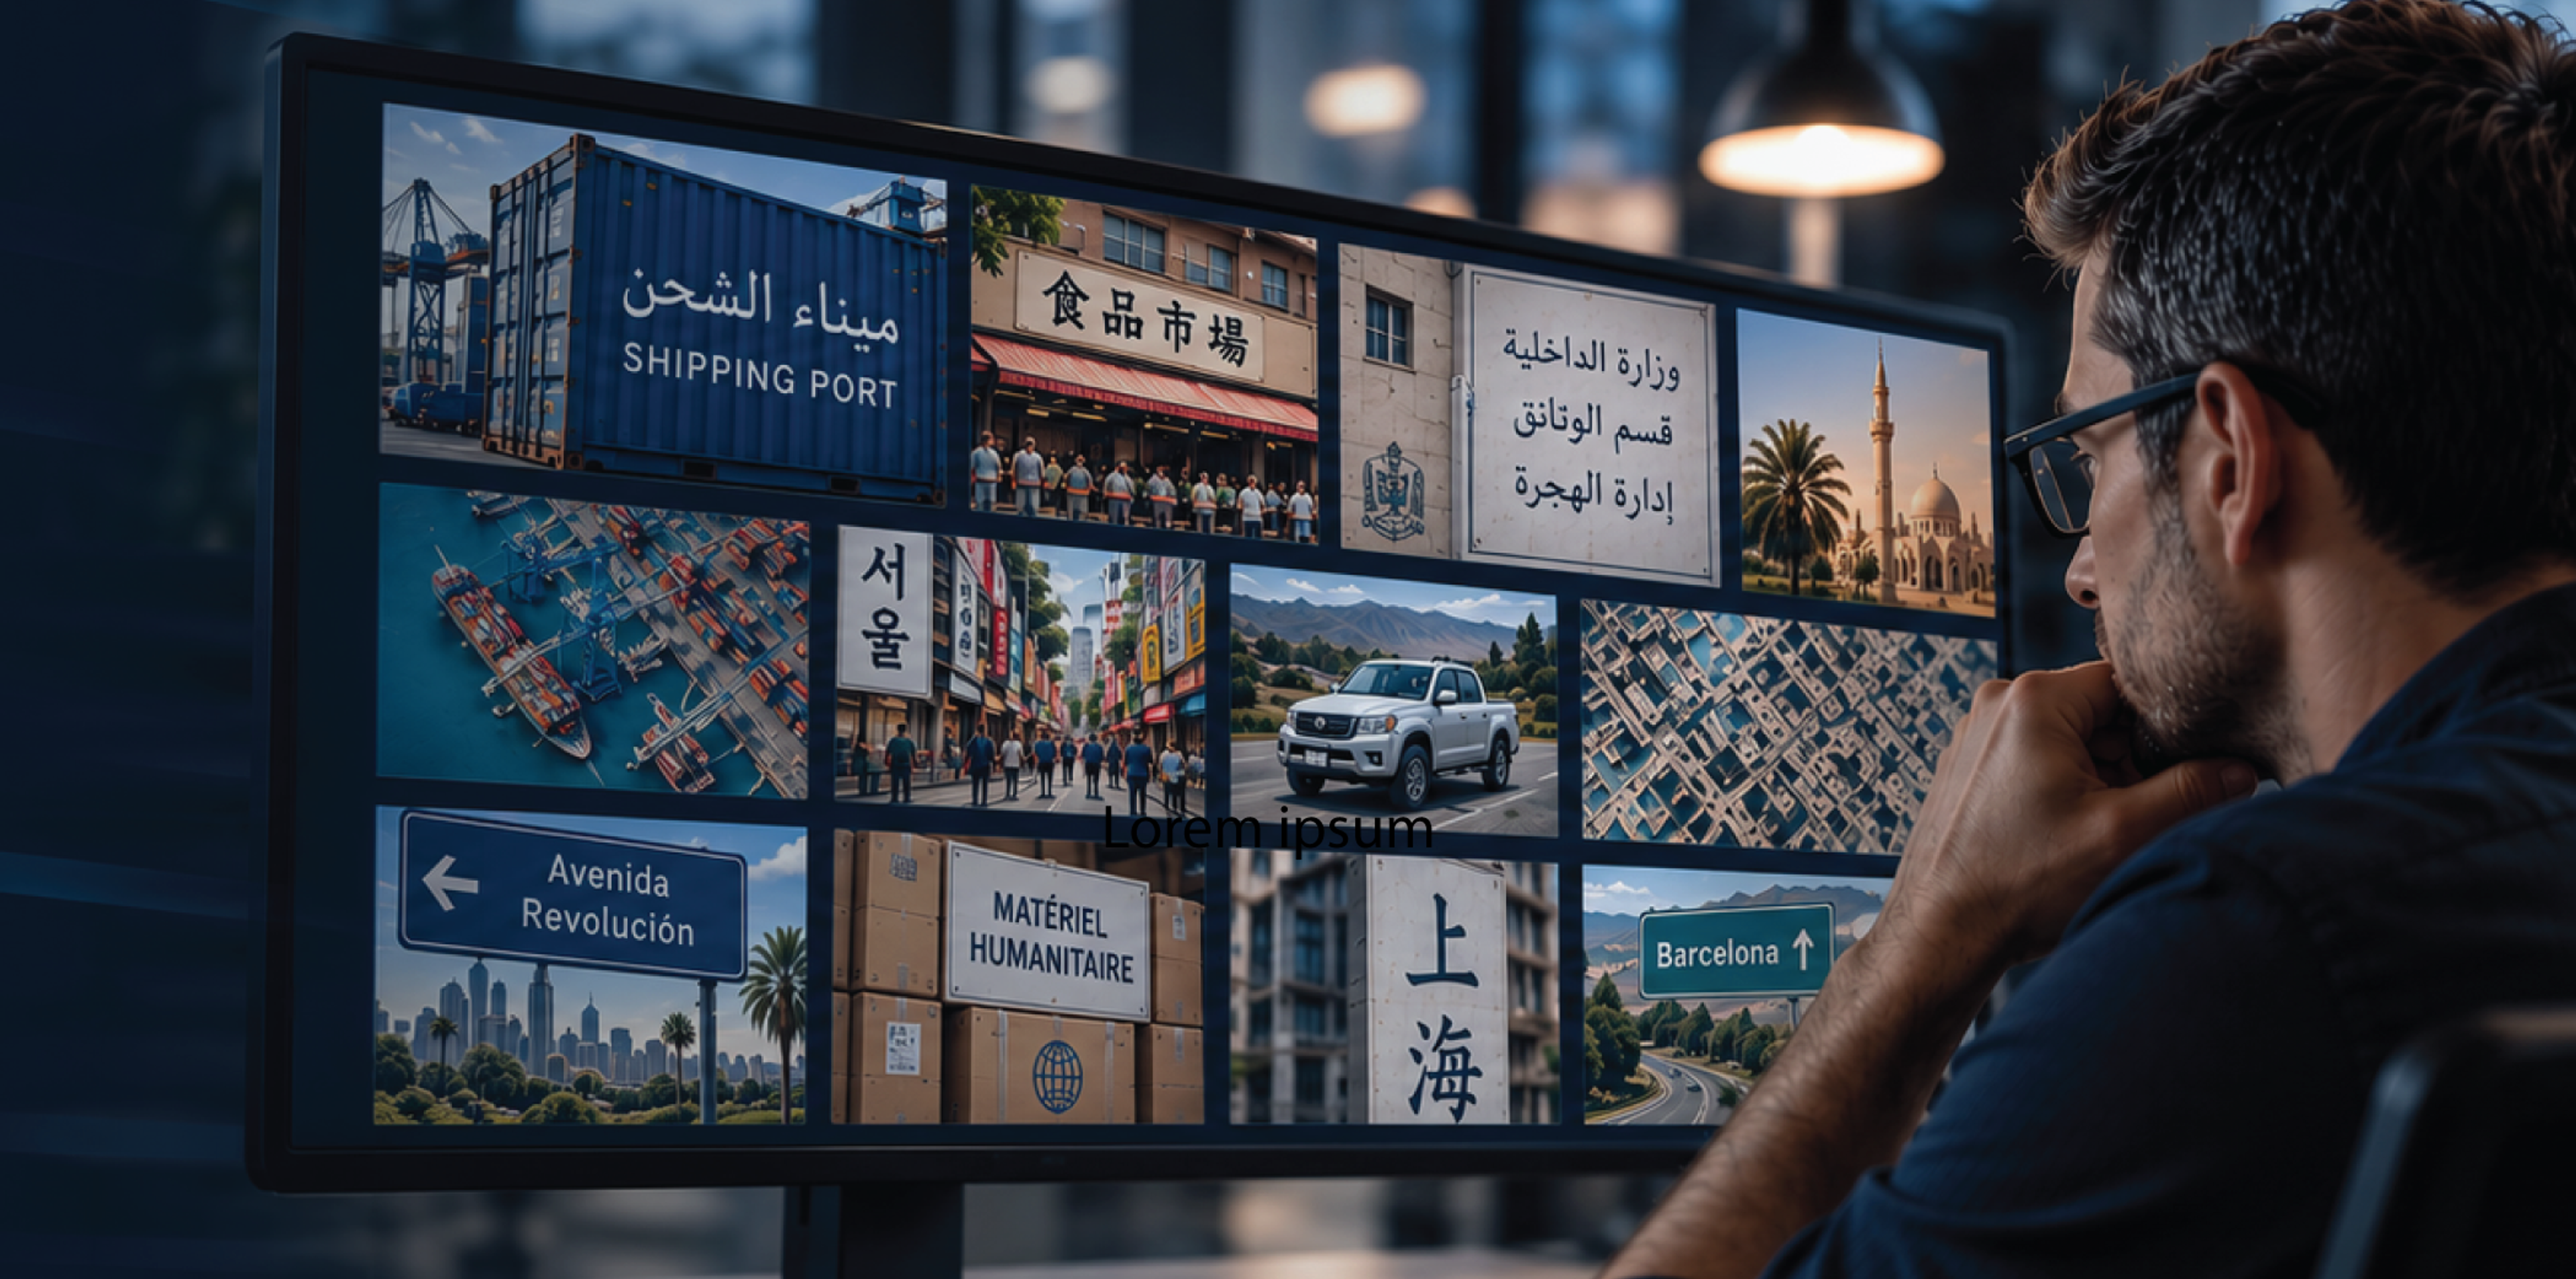
ビジュアルインテリジェンスとは?
ビジュアルインテリジェンスとは、調査と評価を支援するために、画像やその他の視覚メディアに含まれる情報を発見・分析するプロセスです。元の情報源のコンテキストとのつながりを維持しながら、埋め込まれたテキスト、物体、カテゴリー、場所、その他の視覚的シグナルをアナリストが特定するのに役立ちます。
スクリーンショット、写真、スキャン文書、ミーム、インフォグラフィック、動画フレームなどのビジュアルコンテンツは、オンラインでのコミュニケーションにおいて中心的な役割を果たしています。業界調査によると、インターネットトラフィックの約82%を動画が占めており[1]、インターネットユーザーの90%以上がオンライン動画コンテンツを日常的に視聴しています。[2]
多くの調査ワークフローがテキストを中心に構築されているため、調査担当者やアナリストにとって、拡大するインテリジェンスギャップが生じています。
検索結果、アラート、ウォッチリスト、エンティティ分析、レポート作成プロセスは、いずれも文字情報を発見、取得、分析する能力に依存しています。しかし、特に重要なシグナルの一部は、メッセージングチャネルで共有されたスクリーンショット、画像の背景に写り込んだロゴ、スキャン文書、場所を撮影した写真、投稿本文ではなく画像内に埋め込まれたテキストなど、視覚情報として現れるケースが増えています。
その結果、多くの場合、煩雑で時間のかかるプロセスとなります。アナリストは文書を1件ずつ開き、添付メディアを手作業で確認し、画像と付随するテキストを照合して、どの情報が関連するかを判断しなければなりません。対象が大規模になると、こうした作業を継続することが難しくなり、重要なコンテキストを見落とすリスクが高まります。
要点
- 視覚情報には、付随するテキストには含まれていない調査上の手がかりが含まれる場合があります。
- ビジュアルインテリジェンスにより、アナリストは元の情報源との関連性を維持しながら、メディアを発見・分析できます。
- 多言語OCR、画像説明、物体・カテゴリの識別、大規模な画像分析により、手作業による確認を削減できます。
調査におけるビジュアルインテリジェンスの盲点
ほとんどの組織は、テキストを極めて効率的に検索できるようになっています。氏名、キーワード、場所、組織、通信内容を数秒で特定できます。
ビジュアルコンテンツは異なります。
画像は多くの場合、添付ファイル、埋め込みオブジェクト、スクリーンショット、またはより広範なコンテンツ群に関連付けられたメディアファイルとして届きます。そうした画像に関連情報が含まれていても、1件ずつ開いて確認しなければならない文書内に埋もれたままになりがちです。
課題は、単に画像を見つけることにとどまりません。アナリストや実務担当者は、画像に何が含まれているのか、またそれが調査全体とどのように関連しているのかを把握する必要もあります。
写真から場所が判明することがあります。スクリーンショットに重要なテキストが含まれている場合もあります。画像には、付随する文章には一切現れないロゴ、車両、シンボル、その他の文脈上の手掛かりが含まれている可能性があります。視覚コンテンツとテキストコンテンツが分断されたままでは、アナリストが手作業で文脈を再構築しなければなりません。
Babel Street Insightsのビジュアルインテリジェンス機能
Babel Streetは、Insights内のメディアをより利用しやすく、実用的なものにします。
メディアの発見と分析に重点を置くInsightsは、画像、動画フレーム、音声ファイルを1つの画面に集約する専用ワークスペースを提供します。関連するメディアが存在するかを確認するために文書を一つひとつ開く必要はなく、アナリストは検索結果から利用可能なメディアをすばやく確認し、どこに注力すべきかを判断できます。
同様に重要なのは、すべてのメディア項目が出典との関連付けを維持していることです。
アナリストはメディア項目から元の文書へ直接移動できるため、そのコンテンツがどのように、なぜ出現したのかを理解するために必要なコンテキストを維持できます。Visual Intelligenceは、メディアを切り離された成果物として扱うのではなく、調査プロセス全体を通じて視覚コンテンツとテキストコンテンツの関連性を維持します。
画像を検索可能なインテリジェンスに変換
関連するメディアを見つけることは、課題の一部にすぎません。
Insights Visual Intelligenceは、アナリストが発見した画像から追加情報を抽出できるよう設計された画像分析機能も提供します。
アナリストは、多言語OCRを適用して、スクリーンショット、写真、スキャン文書に埋め込まれたテキストを抽出できます。物体とカテゴリーの識別により、調査に関連する可能性のある項目を明確にし、画像の説明からレビューやトリアージに役立つ追加のコンテキストを得られます。得られた情報は、メディアコレクションの絞り込みに活用でき、重要性が最も高いと考えられるコンテンツに注力できます。
この機能は、重要な情報がテキストではなく視覚的に伝達される調査において、特に有用です。調査担当者は、記述された内容だけに依存せず、画像自体に含まれるシグナルも取り入れられます。
大規模調査に対応する設計
メディア分析は、実運用規模で機能してこそ最大の効果を発揮します。
ビジュアルインテリジェンスは、必要な時点での分析と、より大規模な調査ワークフローの両方に対応します。アナリストは、より深い理解が必要な場合には個々の画像を分析できるほか、「すべての画像を分析」ワークフローを使用して大量の画像を処理でき、最大10,000枚の画像を扱うジョブに対応します。
目的は単に画像を分析することではありません。手作業によるレビューの負担を軽減するとともに、アナリストが視覚的シグナルを、検索、調査、評価に日常的に使用しているワークフローへ統合できるようにすることです。
調査の全体像にビジュアルコンテンツを統合
利用可能なビジュアルコンテンツの量は、調査担当者にとって今後も増え続けます。画像、スクリーンショット、スキャン文書、動画は、人々が情報を共有し、考えを伝え、価値ある手がかりを残す主要な媒体になりつつあります。
アナリストは、そのコンテンツを二次的なものとして扱うわけにはいきません。
ビジュアルインテリジェンスは、メディアの発見と理解を容易にし、調査のより広範な文脈との関連付けを可能にすることで、このギャップの解消に貢献します。画像を調査ワークフローに直接取り込むことで、アナリストは視覚的なシグナルの探索に費やす時間を減らし、その意味の把握により多くの時間を充てられます。
よくある質問
ビジュアルインテリジェンスとは
ビジュアルインテリジェンスとは、画像、動画フレーム、スクリーンショット、スキャン文書などの視覚メディアに含まれる情報を、テクノロジーを活用して発見、抽出、分析することです。アナリストが視覚コンテンツを検索可能なインテリジェンスに変換し、調査や評価に活用できるようにします。
ビジュアルインテリジェンスによる調査支援
ビジュアルインテリジェンスは、関連するメディアの検索、物体やカテゴリーの識別、埋め込まれたテキストの抽出、視覚的シグナルと元の情報源との関連付けを支援し、調査をサポートします。これにより、手作業による確認を減らし、調査ワークフロー全体でコンテキストを維持できます。
捜査担当者が画像内のテキストを検索する方法
捜査担当者は、光学文字認識(OCR)を使用して、スクリーンショット、写真、スキャン文書、その他の画像ファイルから文字を検出・抽出し、画像内のテキストを検索できます。抽出されたテキストは、他の調査コンテンツと併せて、より容易に検索、フィルタリング、分析できるようになります。
Babel Street Visual Intelligenceによる大規模な画像コレクションの分析可否
はい。Babel Streetは、最大10,000枚の画像コレクションを処理するワークフローを含む、大規模な画像分析に対応しています。これにより、視覚コンテンツと調査全体との関連性を維持しながら、アナリストは大量のメディアをより効率的にトリアージできます。
出典
1. StreamRecorder「2026年オンライン動画視聴統計」2026年2月、https://streamrecorder.io/research/online-video-consumption-statistics/
2. Marketful「数字で見るビジュアルコンテンツマーケティング:2026年版統計30選」2026年5月、https://marketful.com/visual-content-marketing-statistics
Published